Med statistikfunktionen i Korp kan du se fördelningen av attribut för en sökfråga. Till exempel fördelningen av politiska partier bland motioner som innehåller "krig". Talen i varje rad anger antal token som matchar både sökfrågan och attributvärdet på den raden. Läs mer om statistikfunktionen i användarhandledningen.
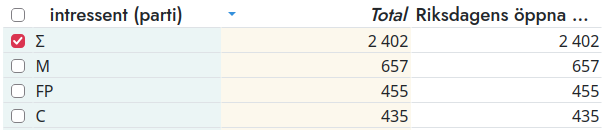
Men hur gör du om du inte vill räkna token, utan antal texter? Vilka ord förekommer i flest antal dokument?
Vi har tyvärr inget särskilt enkelt stöd för att svara på den typen av frågor i nuläget. Men med lite avancerad hantering går det ändå att få fram. Men först behöver du veta vilken typ av attribut det är, vars fördelning du är intresserad av:
- Strukturella attribut gäller oftast hela texten, till exempel författare eller datum, men kan också gälla en mindre beståndsdel som ett stycke eller en namngiven enhet.
- Ordattribut finns på tokennivå, till exempel ordets grundform eller sammansättningsanalys.
Fördelning av strukturella attribut
- Öppna det Avancerade sökläget
- Skriv in CQP-uttrycket
<text> [], som betyder "första tokenet i varje text" - Tryck Sök
- Öpnna resultatfliken Statistik
- Öppna menyn "Sammanställ på", välj bort "ord" och välj något av de strukturella attributen.
- Om du har valt korpusen "Riksdagens öppna data: Motion" kan du till exempel välja attributet "intressent (parti)"
Länk till exempelsökning. Resultatet är en fördelning av partier för precis ett ord i varje text – alltså återspeglar antalet token i det här fallet antalet texter.
Fördelning av ordattribut
Nu duger det inte att plocka ett godtyckligt token från varje text, utan vi vill ta med alla token i beräkningen. Du kan ta fram ett underlag genom Korp och sedan göra beräkningen i ett kalkylprogram som kan hantera pivottabeller.
I det här exemplet har vi analyserat en egen korpus i Mink och sedan installerat den i Korp. Med Minks standardinställningar finns attributen "lemgram" och "text source", alltså källfilens filnamn. Vi vill räkna antalet källfiler som varje lemgram återfinns i.
- Gör en sökning på alla ord: välj Utökad sökning och behåll standardsökningen "ord – är – vilket ord som helst"
- Öppna Statistik-fliken och välj Sammanställ på: "lemgram" och "text source" (välj bort "ord")
- Tabellen du får fram ger alla kombinationer av ett visst lemgram och en viss källfil
- Ladda ner som komma- eller tabbseparerad tabell (tsv- eller csv-fil) genom knappen Exportera
Nu lämnar vi Korp och går vidare i ett separat kalkylprogram. Du kan till exempel använda Numbers, Excel, LibreOffice Calc eller Google Sheets. Proceduren ser lite olika ut i olika program. Detaljerna nedan avser LibreOffice Calc.
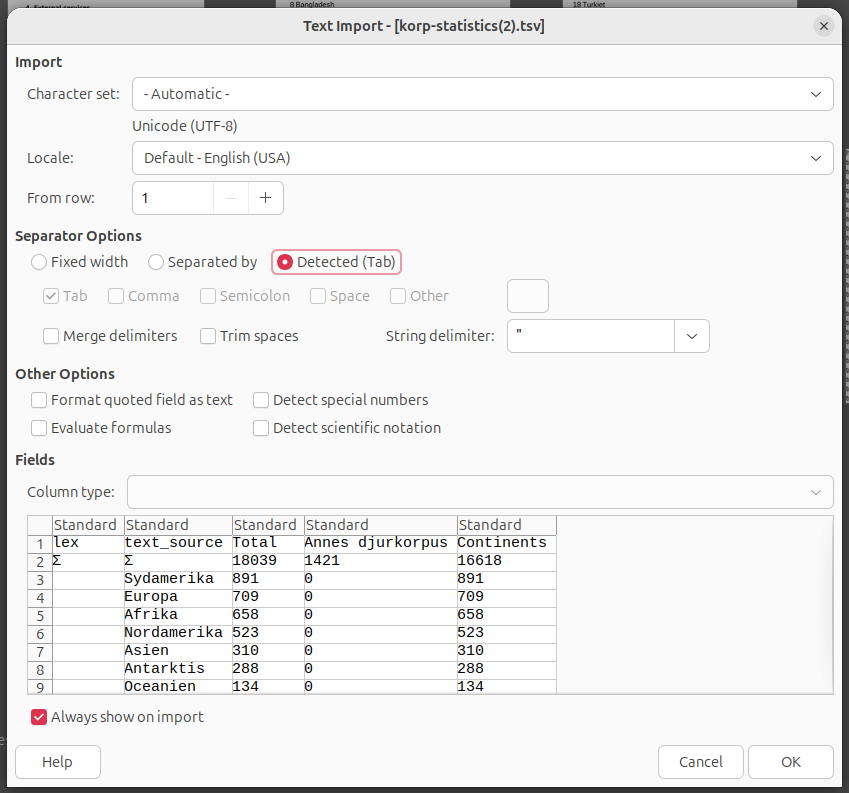
- Öppna den nedladdade filen i kalkylprogrammet. Ett importfönster med olika alternativ visas. Kontrollera att förhandvsningen ser korrekt ut (dvs att kolumnerna är indelade som i Korp), justera annars alternativen, tryck sedan OK. Notera att det tekniska namnet för lemgram är "lex"
- Skapa en pivottabell för att göra en ny sammanställning:
- Öppna menyn "Data" och välj "Pivot Table" > "Insert or edit"
- Välj "Current selection" (alla celler med innehåll är valda) och tryck OK
- I layoutrutan, dra "lex" från "Available fields" till "Row fields"
- Dra "text_source" från "Available fields" till "Data", så att det blir "Sum - text_source"
- Dubbelklicka på "Sum - text_source", byt funktion till "Count" och tryck OK, så att det blir "Count - text_source"
- Tryck OK
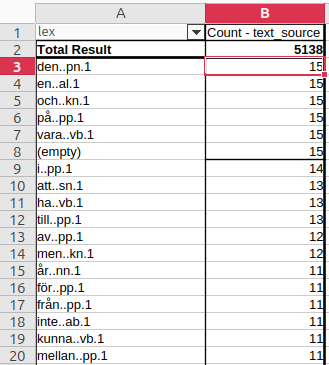
- Pivottabellen som skapas räknar antalet rader sammanställt på lemgram, alltså antalet källor per lemgram
- Sortera på antal källor genom att markera cellen "Count - text_source", öppna menyn "Data" och välj "Sort descending"